


全球书商近期收到了大量异常订单。在英国诺森伯兰郡经营巴特书店的斯图尔特·曼利,过去每周能卖出两三千本二手书。但最近一家加拿大公司的一笔订单就相当于他一周的销量,这是他在二手书行业从业30年来从未见过的情况。
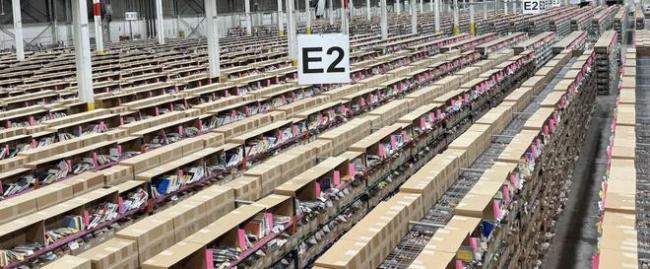
美国休斯顿贝克书店的经理查理·贝克也遇到了类似情况,近期他卖给了同一个买家95本书,其中有一单就70本。这些书籍几乎全部是非虚构类,大多出版于20世纪70年代至90年代。爱尔兰的肯尼斯书店也曾收到5000本书的订单,书目包括地区历史书、18世纪非洲的农具书籍、20世纪50年代赛车手的传记以及非常冷门的金融指南,几乎没有主题规律。
书商开始怀疑这些买家可能是通过自动化系统按照国际标准书号(ISBN)寻找AI训练数据还没有覆盖的书。社交媒体上也有用户讨论了这一现象,自称是书商的用户纷纷讲述了他们收到异常大宗订单的经历。采购者很多都是中间商,并非直接来自AI公司。例如,总部位于加拿大的Zoom Books自称为“北美领先的图书回收公司”,利用智能物流每月采购、分类和转售超过200万册图书,全球多个国家的书商都收到过这家企业的订单。
在荷兰,一些书商收到了来自新加坡机构2077AI的电子邮件。该机构声称正在革新人工智能数据,其部分工作是创建训练数据集。该公司发送的邮件附带了一份包含3000种英文书籍的清单,其中包括《地质力学中的离散元建模》等学术著作。
对于出版行业来说,这一现象已经成为热门话题。一名匿名的英国二手书商表示,尽管买家批量订购,但他们支付的价格非常高,而且没有要求折扣。书商们猜测,人工智能公司正在收购大量书籍,扫描其内容后再将其销毁。
2025年,在三位作家对人工智能公司Anthropic提起的版权诉讼后,法官裁定以购买书籍的方式来训练人工智能软件并不违反美国版权法。法庭文件显示,Anthropic曾花费数千万美元收购数百万本书,拆除书脊,扫描书页来训练语言大模型Claude,这一项目被称为“巴拿马项目”。被拆除书籍范围广泛,从晦涩难懂的拉丁文文献到西部牛仔小说都有。Anthropic回应称,他们在书籍中寻找训练模型的材料是人工智能行业的普遍做法,不会购买和销毁珍稀古籍。
在另一起诉讼中,Anthropic还被发现在盗版网站下载了大量电子版书籍用来训练模型。最终,Anthropic同意向出版商和作者支付15亿美元的和解金,以避免审判。书籍被下载的作者可以申请获得和解金,预计每本书的赔偿金额约为3000美元。
专家表示,人工智能公司正面临自身造成的数据难题:开放网络充斥着人工智能生成的文本,用这些“垃圾”训练新模型会导致性能下降。而不寻常和罕见的文本可以为改进大型语言模型的训练提供新的素材,这对生成式人工智能工具的发展至关重要。Anthropic的一位联合创始人认为,用书籍训练人工智能模型可以教会它们如何写出好文章,而不是模仿低劣的网络用语。Meta公司2024年的内部邮件也将获取数字书籍资源描述为与人工智能竞争对手抗衡的关键。
对于珍惜纸质书的二手书商来说,这一过程让他们尤为不安。爱丁堡二手书店老板德里克·沃克称,他出售的一些书籍是目前已知的唯一幸存的18世纪版本,如果这些书籍被销毁,将造成不可挽回的损失。
恒汇证券提示:文章来自网络,不代表本站观点。


